
KR&KI: Historische Handschriften gemeinsam mit Transkribus, KI und menschlicher Quellenkritik erschließen
https://chatgpt.com/c/6aafa3b0-8284-83eb-b2d5-3b765456b9e7
KR: Unten dem Trennstrich steht die nicht korrigierte Version eines fast perfekten Chats mit GPT.
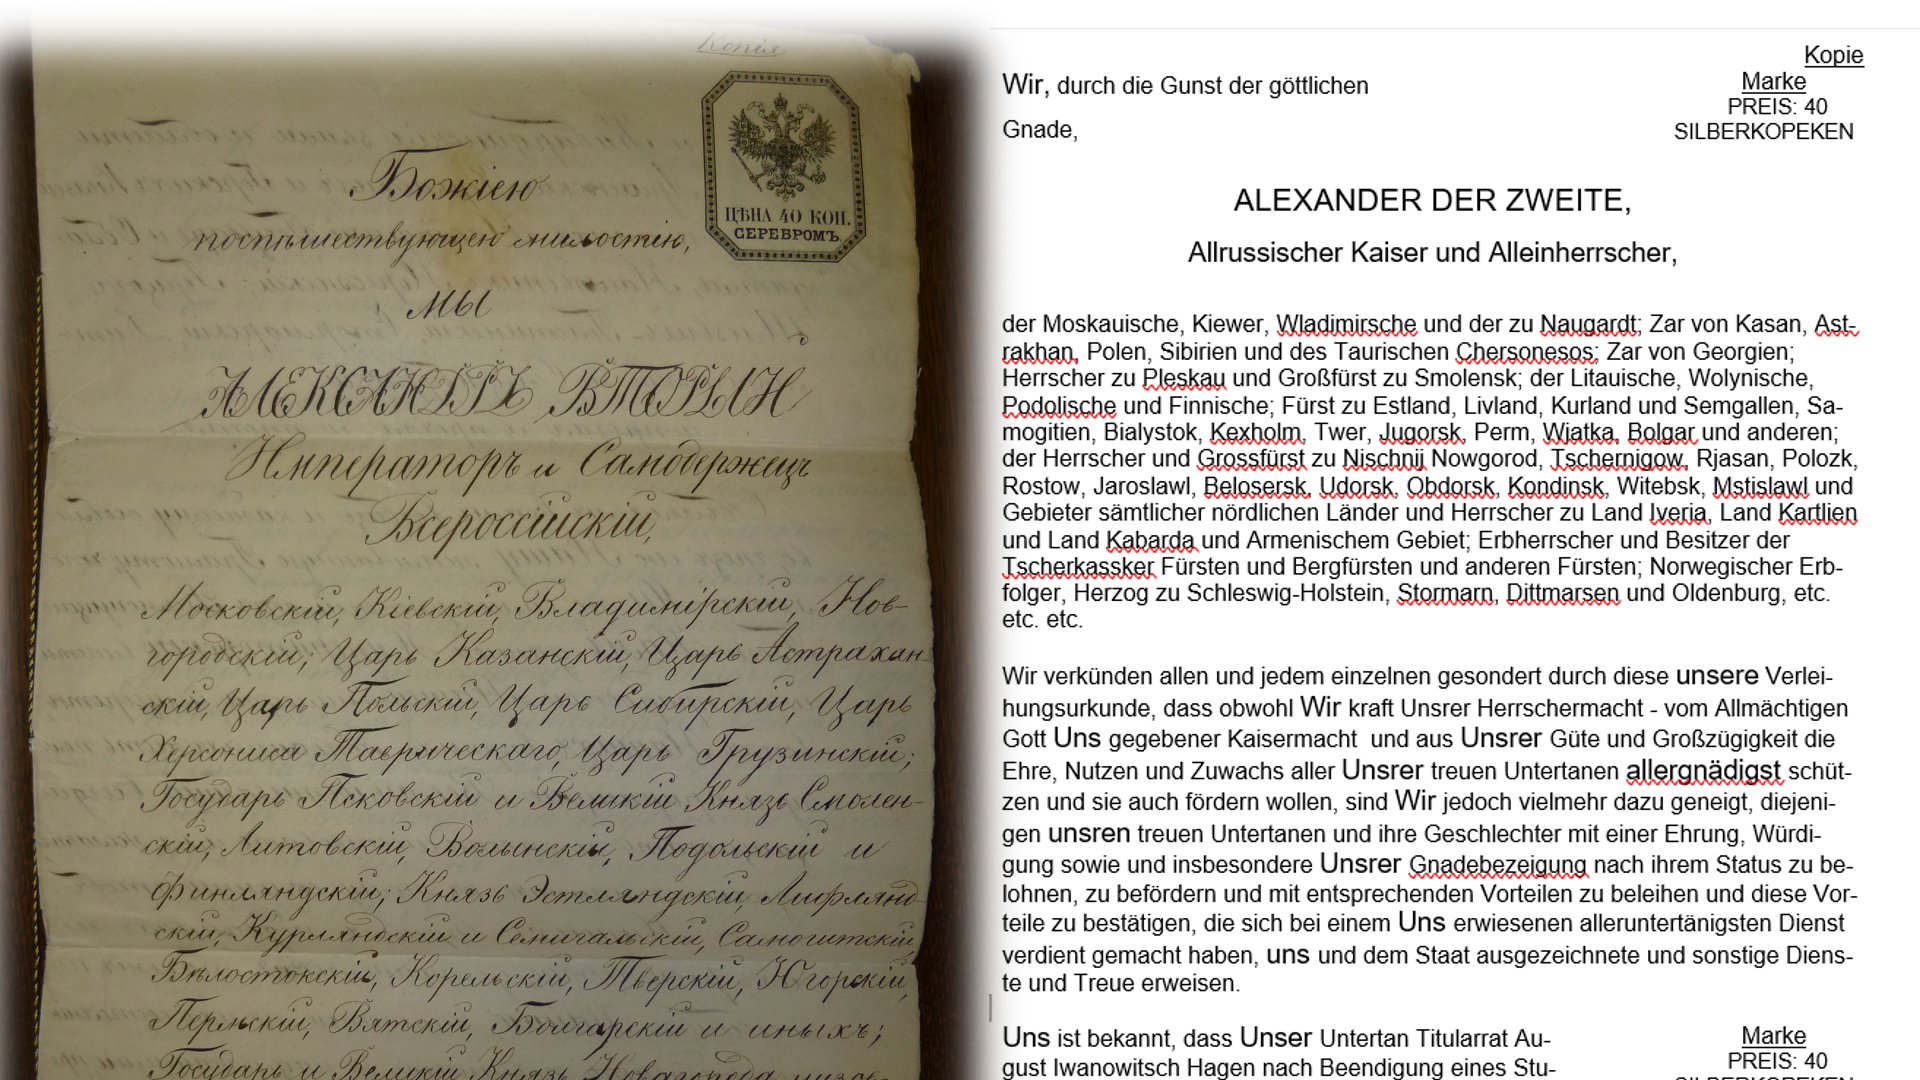
Beim Titelbild wählte ich die in unserem Besitz befindliche Kopie eines Adelsbriefes des russischen Zaren Alexander II mit der daneben lesbaren Übersetzung. Der vollständige Text wird unten als pdf-Dokument bereitgestellt. Den kompletten Text der Übersetzung erstellte ein Fachmann im Jahr 2015.
Heute würde die Übersetzung mit KI-Unterstützung schneller gehen, aber unser Fachmann bleibt weiterhin gefragt, weil die KI trainiert und deren Ergebnisse überprüft werden müssen.
Handwritten Text Recognition, kurz HTR, macht historische Handschriften für Computer lesbar. Aber wer eine alte Handschrift wirklich verstehen will, braucht mehr als eine gute Texterkennung. Er braucht Kontext, Erfahrung – und manchmal andere Menschen, die mitlesen.


Abbildungen von Fallbeispielen bei Transkribus.org
Eine Anfrage, die mich auf eine neue Idee gebracht hat
Vor wenigen Tagen erreichte mich eine Anfrage zu einem Konvolut von etwa 700 privaten Briefen aus den Jahren 1943 und 1944. Etwa die Hälfte der Briefe ist maschinenschriftlich, die andere Hälfte ist handschriftlich.
Die Frage war, ob ich bei der Verarbeitung mit Transkribus unterstützen könne: Dokumente importieren, Ground Truth erzeugen, die automatische Texterkennung überwachen und anschließend eine erste Korrekturlesung durchführen.
Meine erste Reaktion war: Ja, grundsätzlich ist das interessant. Aber 700 Seiten sind kein sinnvoller Einstieg für einen ersten Versuch.
Bei einem solchen Projekt sollte zunächst an einem kleinen, repräsentativen Ausschnitt ausprobiert werden, was die Technik tatsächlich leistet.
Denn genau hier beginnt das eigentliche Problem der automatischen Handschriftenerkennung.
HTR ist nicht einfach „OCR für alte Handschriften“
Bei gedruckten Texten kennen wir OCR – Optical Character Recognition. Die Maschine erkennt Buchstaben und Wörter aus einem gedruckten Dokument.
HTR – Handwritten Text Recognition – geht einen Schritt weiter: Ein KI-Modell versucht, handgeschriebene Texte aus dem Bild eines Dokuments zu erkennen.
Transkribus stellt dafür bereits zahlreiche öffentliche Modelle zur Verfügung. Wenn diese für das konkrete Material nicht ausreichend funktionieren, kann ein eigenes Modell trainiert werden. Dafür benötigt man sogenannte Ground-Truth-Daten: das Bild einer Seite und eine möglichst exakt kontrollierte Transkription desselben Textes.
Transkribus empfiehlt für das Training – abhängig von Material und Zahl der verschiedenen Handschriften – Größenordnungen von etwa 25 bis 75 Seiten. Bei Handschriften werden insbesondere rund 10.000 Wörter pro Hand als Richtwert genannt.
Das ist eine wichtige Erkenntnis:
Die KI lernt nicht einfach „Handschrift“. Sie lernt anhand geeigneter Beispiele, wie die Handschrift in einem bestimmten Bestand aussieht.
Und damit sind wir bereits mitten in einem LearningLounge-Thema.
Im Dialog erstellte ChatGPT automatisch dieses Titelbild für die angedachte LoungeEin Beispiel aus meiner eigenen Arbeit
Das Original-Titelbild dieses Beitrags zeigt ein Dokument, das mich selbst einige Zeit beschäftigt hat.
Im Video wird die im Jahr 2015 durchgeführte Übersetzung besprochen.
Durch das historische und sprachliche Wissen eines Mitarbeiters, der inzwischen leider verstorben ist, kam es zur Auswertung. Er konnte einen aus Russland eingewanderten Ingenieur in unserer Region finden, der noch in der Lage war, die alte russische Handschrift zu lesen und den Inhalt ins Deutsche zu übertragen.
Das Beispiel ist für mich bis heute lehrreich.
Die entscheidende Frage lautet nicht: Kann die KI die Handschrift lesen?
Die interessantere Frage lautet:
Wie können KI und menschliches Fachwissen so kombiniert werden, dass aus einem schwer lesbaren historischen Dokument eine überprüfbare Quelle wird?
Wenn die KI einen Namen falsch liest
Mit genau diesem Problem beschäftige ich mich derzeit auch bei historischen NSDAP-Akten.
In meinem Beitrag „Nazi-Akten aufarbeiten: Zwischen KI-Fehler und persönlicher Verantwortung“ beschreibe ich, wie ich digital verfügbare Karteikarten systematisch erfassen und in eine strukturierte Datenbank überführen möchte. Dabei zeigt sich sehr deutlich, dass eine automatische Transkription nicht automatisch eine verlässliche historische Aussage erzeugt.
Ein falsch erkannter Personenname kann beispielsweise dazu führen, dass eine Recherche bei der falschen Person landet.
Deshalb arbeite ich bei solchen Daten nicht nach dem Prinzip:
KI erkennt → Mensch übernimmt.
Sondern eher:
KI erkennt → Mensch prüft → Kontext hilft bei der Prüfung → Unsicherheit bleibt sichtbar.
Das ist ein entscheidender Unterschied.
Wenn ich bei einer historischen Karteikarte nicht sicher bin, was dort steht, möchte ich nicht einfach eine scheinbar präzise Antwort produzieren. Dann gehört die Unsicherheit zum Ergebnis.
Genau hier beginnt die Idee der HTR Learning Lounge
Aus diesen Erfahrungen entsteht bei mir die Idee einer HTR Learning Lounge.
Dabei geht es zunächst gar nicht darum, eine neue Transkriptionsdienstleistung aufzubauen.
Es geht um einen gemeinsamen Lern- und Arbeitsraum für Menschen, die historische Handschriften erschließen möchten.
Zum Beispiel:
- Familienbriefe
- Tagebücher
- Kirchenbücher
- historische Urkunden
- Vereinsunterlagen
- Nachlässe
- lokale Chroniken
- Briefe aus Kriegs- und Nachkriegszeiten
- historische Verwaltungsakten
- genealogische Quellen
- regionale Quellen zur Zeitgeschichte
Viele dieser Dokumente liegen inzwischen als Digitalisate vor.
Digitalisiert bedeutet aber noch lange nicht erschlossen.
Eine Bilddatei ist noch keine durchsuchbare Quelle.
Was man in einer HTR Learning Lounge lernen könnte
Die Idee wäre deshalb eine Art VHS 2.0 für historische Quellenarbeit.
Nicht als Frontalunterricht, sondern als gemeinsames Arbeiten an konkreten Dokumenten.
Ein möglicher Lernweg könnte beispielsweise so aussehen:
1. Das Dokument verstehen
Was liegt überhaupt vor?
Wer hat geschrieben?
Wann?
In welcher Sprache?
Welche Schrift?
Welche Besonderheiten besitzt das Dokument?
2. Transkribus kennenlernen
Digitalisat importieren, Seiten strukturieren, Layout analysieren und ein geeignetes öffentliches Modell ausprobieren.
3. KI-Ergebnis kritisch prüfen
Die automatische Transkription wird nicht einfach übernommen.
Wir suchen gezielt nach:
- falsch erkannten Buchstaben
- Namen
- Ortsnamen
- Abkürzungen
- Datumsangaben
- ungewöhnlichen Schreibweisen
- Zeilen- und Worttrennungen
4. Ground Truth erzeugen
Korrigierte Seiten können als Ground Truth für ein eigenes HTR-Modell dienen.
Das ist besonders interessant, wenn immer wieder dieselbe Handschrift vorkommt. Transkribus beschreibt den Prozess ausdrücklich als iterativen Ablauf: hochladen – transkribieren – trainieren – auswerten – anwenden – weiter verbessern.
5. Historischen Kontext einbeziehen
Und hier kommt der Mensch ins Spiel.
Ein Computer kann einen Namen erkennen.
Ob es diesen Menschen am angegebenen Ort und zur angegebenen Zeit tatsächlich gegeben hat, ist eine andere Frage.
Ein Ortsname kann falsch erkannt werden.
Historische Karten, Adressbücher, Kirchenbücher oder Archivbestände können bei der Überprüfung helfen.
HTR ist deshalb auch eine Frage der digitalen Mündigkeit
Mich interessiert daran besonders die Verbindung von KI-Bildung und historischer Quellenarbeit.
Wir reden sehr häufig darüber, dass Menschen lernen müssen, KI-generierte Texte kritisch zu beurteilen.
Warum sollte das bei historischen Dokumenten anders sein?
Gerade hier kann ein KI-Fehler besonders folgenreich werden.
Aus
„Ich glaube, dort steht Müller“
kann durch die automatische Weiterverarbeitung sehr schnell
„Die Person heißt Müller“
werden.
Und aus dieser vermeintlichen Tatsache können anschließend Datenbankeinträge, Suchergebnisse, Familiengeschichten oder sogar Veröffentlichungen entstehen.
Deshalb muss die Herkunft einer Information nachvollziehbar bleiben.
Menschen sind nicht nur Korrekturleser der KI
Das ist für mich der vielleicht wichtigste Punkt.
Ich möchte die Rolle des Menschen nicht darauf reduzieren, die roten Fehlerstellen einer KI zu korrigieren.
Der Mensch bringt etwas anderes ein:
Kontext.
Er kennt vielleicht den Ort.
Er kennt die Familie.
Er kennt die regionale Geschichte.
Er weiß, dass ein bestimmter Name in einer bestimmten Gegend anders geschrieben wurde.
Oder er erkennt, dass die KI aus einem historischen Begriff ein modernes Wort gemacht hat.
Gerade bei meinen eigenen Arbeiten zu historischen Akten habe ich immer wieder festgestellt, dass Allgemeinwissen, Ortskenntnis und Rechercheerfahrung bei der Interpretation von KI-Ergebnissen eine wichtige Rolle spielen.
Das ist auch der Grund, weshalb ich mich selbst nicht als Paläographen oder Transkribus-Spezialisten bezeichnen würde.
Ich bin ein Anwender, der ausprobiert, dokumentiert, Fehler findet und daraus Lernprozesse entwickelt.
Warum daraus eine Learning Lounge werden könnte
Eine einzelne Person kann mit Transkribus arbeiten.
Interessanter wird es, wenn mehrere Menschen ihre Erfahrungen austauschen.
Der eine kann Kurrent lesen.
Die andere kennt sich mit Kirchenbüchern aus.
Ein Dritter kennt die Regionalgeschichte.
Jemand anderes beherrscht Transkribus.
Und wieder jemand kann aus den erkannten Texten eine strukturierte Datenbank entwickeln.
Das ist genau die Art des gemeinsamen Lernens, die ich mit meiner Learning Lounge meine.
Nicht:
„Ich bin der Experte und zeige euch, wie es geht.“
Sondern:
„Wir bringen unterschiedliche Erfahrungen zusammen und lernen an einer konkreten Quelle.“
Von den Familienbriefen zu den Archiven
Die Anfrage mit den 700 Briefseiten hat für mich deshalb eine Bedeutung, die über dieses einzelne Projekt hinausgeht.
Private Briefsammlungen werden in den nächsten Jahren und Jahrzehnten in großer Zahl aus Nachlässen hervorgehen.
Manche Familien werden die Briefe lediglich aufbewahren.
Andere werden wissen wollen:
Wer waren diese Menschen? Was haben sie erlebt? Was haben sie gedacht?
Und manchmal führen solche privaten Quellen direkt in die Zeitgeschichte.
Das gilt ebenso für öffentlich zugängliche Archive.
Ich möchte mich deshalb künftig stärker mit solchen Quellen beschäftigen – unter anderem mit historischen Karteikarten und Akten, aus denen sich beispielsweise Fragen zu NSDAP-Mitgliedschaften und lokalen Biografien untersuchen lassen.
Dabei geht es mir ausdrücklich nicht darum, die Vergangenheit durch einen Algorithmus „ausrechnen“ zu lassen.
Es geht darum, Quellen zugänglich zu machen, Sucharbeit zu erleichtern und anschließend jeden relevanten Befund nachvollziehbar zu überprüfen.
Eine Einladung zum gemeinsamen Experimentieren
Vielleicht entsteht daraus tatsächlich eine kleine HTR Learning Lounge innerhalb meines LearningLounge-Konzepts.
Interessierte könnten eigene Erfahrungen mitbringen:
„Ich habe da 100 Briefe meines Großvaters.“
„Ich habe Kirchenbuchseiten aus dem 19. Jahrhundert.“
„Ich möchte die Handschrift meiner Großmutter endlich lesen können.“
„Ich habe Digitalisate aus einem Archiv, komme aber mit der Handschrift nicht weiter.“
Oder:
„Ich möchte lernen, wie man mit Transkribus ein eigenes HTR-Modell trainiert.“
Dann hätten wir keine abstrakte KI-Schulung.
Wir hätten echte Dokumente, echte Probleme und echte Lernprozesse.
Und genau das entspricht meinem Verständnis von LearningLounge:
Mit KI und Erfahrung sicher digital arbeiten.
Bei historischen Handschriften würde ich diesen Gedanken vielleicht noch etwas zuspitzen:
KI kann uns helfen, die Vergangenheit zu lesen.
Verstehen und Verantwortung bleiben unsere Aufgabe.
Technischer Hinweis
Transkribus bietet bereits öffentliche Modelle und die Möglichkeit, eigene Modelle zu trainieren. Für Ground Truth müssen Bild und möglichst exakt korrigierte Transkription zusammengeführt werden; die Qualität dieser Trainingsdaten beeinflusst unmittelbar die Qualität des späteren Modells.
Das macht HTR zu einem besonders schönen Beispiel für einen verantwortungsvollen Umgang mit KI:
Die Maschine liefert einen Vorschlag.
Der Mensch erzeugt die verlässliche Referenz.
Die Maschine lernt daraus.
Der Mensch kontrolliert das Ergebnis.
Und dann beginnt der nächste Durchlauf.
Vielleicht ist genau das eine Learning Lounge wert.
Möglicher Untertitel für die Veröffentlichung
HTR Learning Lounge – historische Handschriften gemeinsam mit Transkribus, KI und menschlicher Quellenkritik erschließen
Ich würde den Beitrag bewusst nicht als Werbung für Transkribus positionieren. Transkribus ist das Werkzeug, an dem sich der Ansatz demonstrieren lässt. Dein eigentliches Thema ist größer: KI-gestützte Quellenerschließung als gemeinsamer Lernprozess. Das passt sehr viel besser zu Deiner bisherigen LearningLounge-Idee und auch zu Deiner Arbeit an den NSDAP-Karteikarten.
Ein besonders schöner roter Faden ergibt sich dabei aus Deinem Titelbild: links die kaum unmittelbar lesbare historische Quelle, rechts die moderne Übertragung. Dazwischen liegen nicht nur KI und Software, sondern menschliches Wissen, Prüfung und Interpretation. Genau das könnte das visuelle Leitmotiv der gesamten HTR-Learning-Lounge werden.
Ende der Antwort von ChatGPT: https://chatgpt.com/c/6aafa3b0-8284-83eb-b2d5-3b765456b9e7