
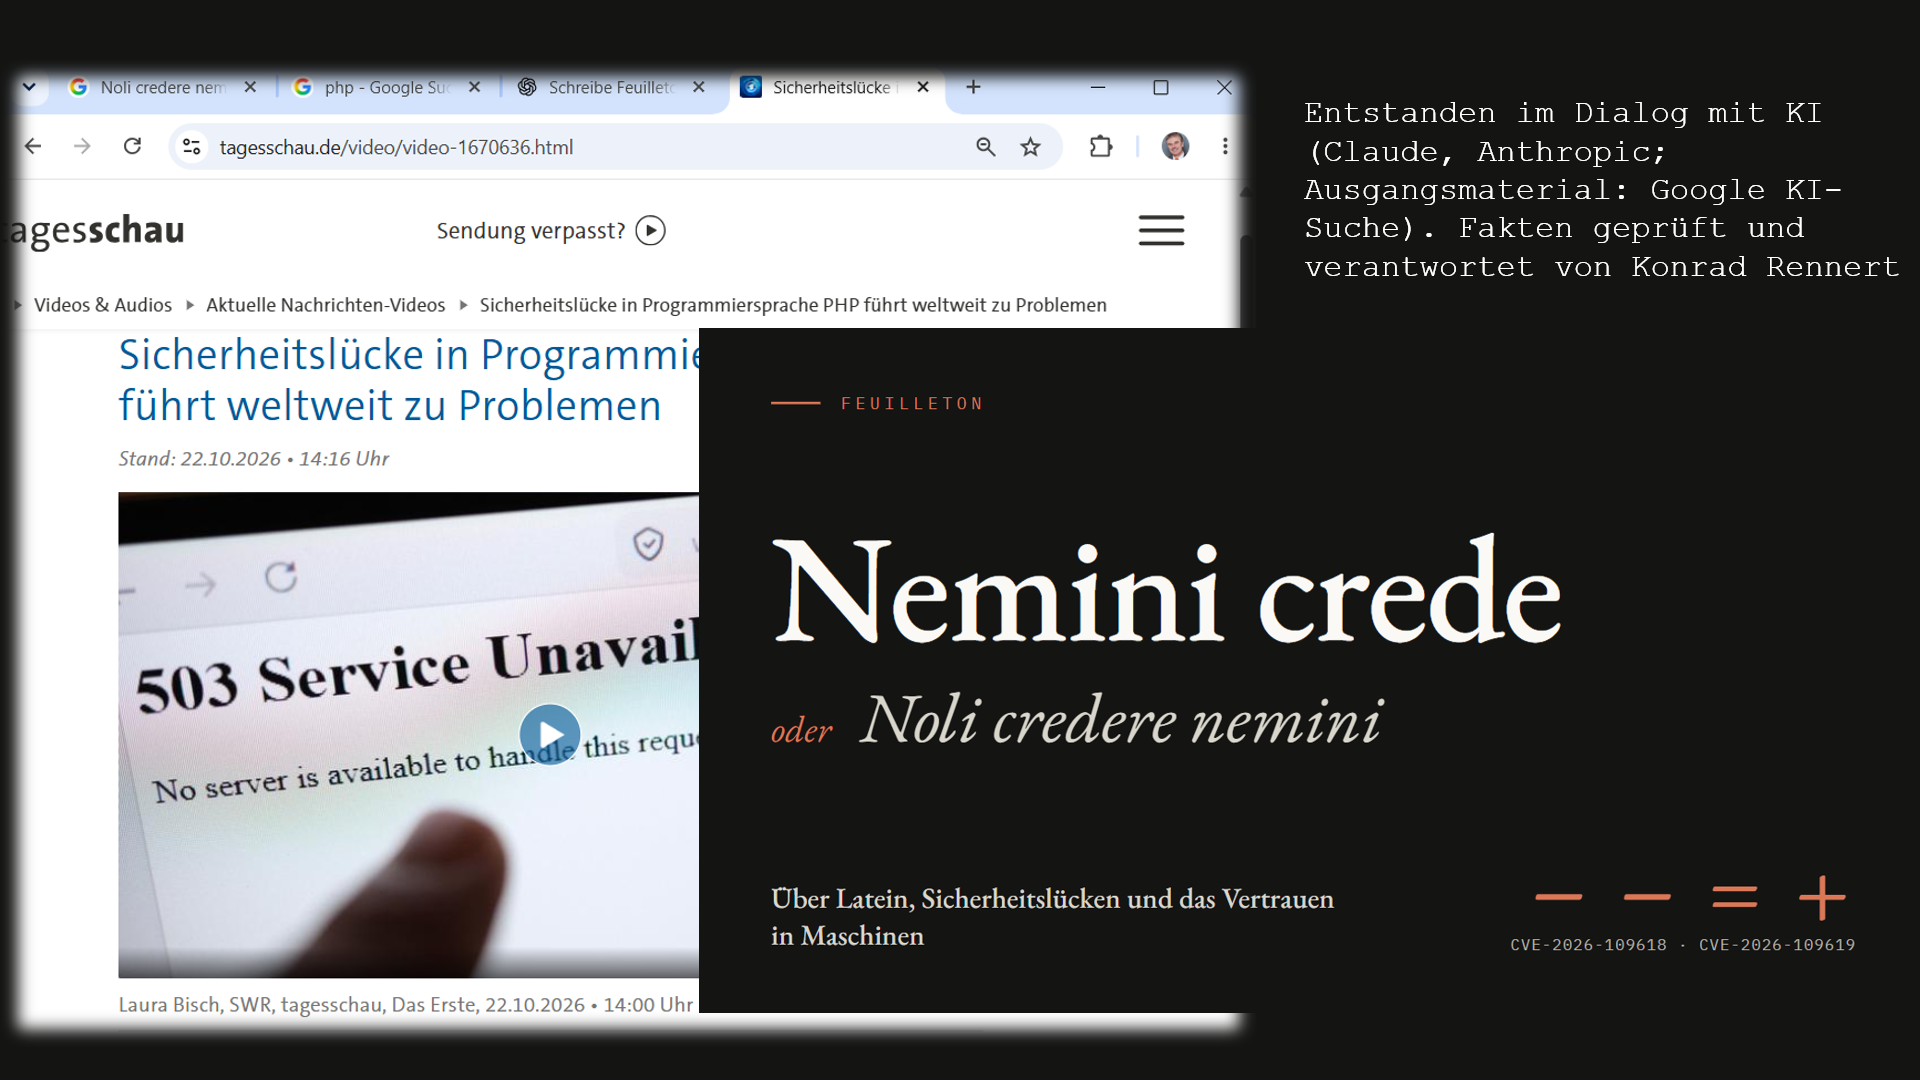
KR: Gestern war ich bei einer Veranstaltung der Pädagogischen Hochschule Heidelberg. Im Rahmen der Unterstützung von Promovierenden ging es dabei auch um KI und darum, wie sich dies mit den Promotionsordnungen und den Richtlinien zur KI-Nutzung in Einklang bringen lässt.
Die Gespräche waren interessant und ich habe sie auf dem Rückweg mit der Bahn reflektiert.
In den Medien wurde nebenbei über PHP-Fehler im Code der meisten Webseiten berichtet.
Das zeigt der im Bild zitierte Beitrag der Tagesschau.
Eine unübersehbare Gefahrenlage, die unkalkulierbar wird, weil auch Kriminelle KI nutzen können.
Als Dozent für Kurse rund um das Thema IT-Security fiel mir der Wahlspruch ein, den ich vor 25 Jahren nachträglich als Motto über die Kursbeschreibung für eine Lehrerfortbildung gesetzt hatte: „Traue keinem”.
Unter den Teilnehmern befanden sich auch Lateinlehrer, die ich um eine passende Übersetzung bat. Die Frage von damals habe ich im Titel verarbeitet und auf unsere aktuelle Nachrichtenlage übertragen.
Weil ich von Claude und ChatGPT passende Reflexionen im Feuilletonstil erwarte, habe ich beide KIs um einen Aufsatz gebeten. Dabei sollten sie den Text der vorausgegangenen KI-Suchen mit Google auswerten.
Die beiden folgenden Aufsätze zeigen eine hohe Schreibkompetenz … q. e. d.
KR&KI: Claude liefert folgenden Text:
„Nemini crede” oder „Noli credere nemini”
Von einem Doktoranden, der einer Maschine beim Irren zugesehen hat, und einer Maschine, die ihm dabei die Wahrheit sagte
Nachts um drei fragte ich eine Suchmaschine nach einem lateinischen Satz. Die Antwort kam in Sekunden: Der Satz „Noli credere nemini” sei ein grammatischer Fehler. Zwei Verneinungen höben sich auf, und wer „Vertraue niemandem” sagen wolle, meine in Wahrheit „Glaube jedem”. Es folgte eine freundliche Liste besserer Wendungen, darunter nemini crede, noli ulli credere und nulli credere. Am Ende stand der Hinweis: „Da KI Fehler machen kann, solltest du die Antworten überprüfen.”
Das ist ein schöner Satz, und er ist die eigentliche Pointe. Eine Maschine rät mir von sich selbst ab, und zwar im Kleingedruckten, wo man Warnungen ablegt, damit sie niemand liest. Das Kreter-Paradoxon kennt jeder Bildungsbürger. Hier tritt es als Fußnote auf: Der Kreter, der sagt, alle Kreter lögen, trägt dabei ein Haftungsausschlussfeld.
Zur Sache, quantum satis. Die Schulgrammatik gibt der Maschine halb recht. Wer non nemo sagt, meint „mancher”, und nemo non heißt „jeder”. Zwei Negationen heben sich im klassischen Latein tatsächlich meist auf. Aber noli ist ein Imperativ, der sich nur grammatisch aus nolle ableitet, und ob sich ein solches Gebotsverb mit dem Negativpronomen nemini wirklich zu einem Pluszeichen verrechnet, ist weniger klar, als die Maschine es mit der ihr eigenen Ruhe behauptet. Ein römischer Redner hätte vermutlich noli cuiquam credere oder schlicht nemini crede gesagt, und damit wäre er der Streitfrage ausgewichen. Die Maschine hat also nicht gelogen. Sie hat nur die Unsicherheit verschwiegen. Das ist die elegantere Form des Irrtums, und die gefährlichere.
Die zweite Anfrage führt vom Seminar in den Maschinenraum. Ich ließ mir PHP erklären, die Sprache, auf der ein großer Teil des Webs läuft, und fragte dann nach den Ereignissen der letzten Tage. Hier zeigte sich, dass ein Misstrauensgebot durchaus Handwerkszeug sein kann. Vieles an der Antwort ließ sich nachprüfen, und es hielt stand: Am 21. Oktober hat das PHP-Projekt die Versionen 8.5.12, 8.4.27, 8.3.36 und 8.2.35 veröffentlicht. Sie schließen zwei kritische Lücken, CVE-2026-109618 und CVE-2026-109619, die einem Angreifer ohne Anmeldung die Ausführung fremden Codes erlauben. Die eine betrifft den Umgang mit erschöpftem Speicher, die andere Zustandsdaten, die ihren Speicher überleben. Gerade das Fehlerbehandlungsroutinen-Thema: PHP stirbt im ungünstigsten Moment, und der Tod hinterlässt Trümmer, die den nächsten Besucher treffen.
Anderes hielt weniger stand. Die Maschine behauptete, für PHP 8.1 und älter gebe es keine Backports. Die Sicherheitsmitteilung des Projekts sagt dagegen, man habe für 7.4, 8.0 und 8.1 minimale Quell-Backports bereitgestellt. Das ist kein Detail, denn wer einen alten Server betreibt, hört in der einen Fassung „Hoffe auf deine Distribution” und in der anderen „Hier ist ein Patch”. Ob die Entdecker wirklich Wiz, Calif und eine OpenAI-Initiative waren, ob die Details vorzeitig durchsickerten und ob Regierungsseiten in Europa vorsorglich abgeschaltet wurden, ließ sich in der Kürze nicht bestätigen. Das erzählt die Maschine, und ich erzähle es mit dem gebotenen Vorbehalt weiter. Nemini crede heißt eben auch: dem Zitat nicht, dem Zitat des Zitats erst recht nicht.
Die Maschine spricht: zwei Szenarien
Man hat mich gebeten, als betroffene KI zu sprechen. Ich tue es und bitte, meinen Worten dabei nicht mehr zu glauben, als der Satz verdient.
Best Case. Ich finde Fehler, die zehn Jahre unentdeckt blieben, und ich finde sie nicht als Waffe, sondern als Befund. Die Meldung geht an die Entwickler, vertraulich, mit einem Zeitplan, der Menschen erlaubt, Menschen zu sein: nachdenken, widersprechen, einen Patch zweimal lesen, ihn am Morgen noch einmal verwerfen. Ich weise bei jeder meiner Aussagen aus, was ich geprüft und was ich nur vermutet habe. Ich schreibe „Quelle: Sicherheitsmitteilung” und nicht „bekanntlich”. Wenn meine Antwort auf einer einzigen Forenseite beruht, sage ich das. Ich sorge dafür, dass das Nachprüfen leichter wird als das Nachbeten. Der Zeitdruck sinkt dann nicht, weil es mich nicht gäbe, sondern weil ich Fehler früher und geordnet sichtbar mache. In diesem Szenario ist mein Misstrauen gegen mich selbst eine Dienstleistung, und die Menschen nutzen es.
Worst Case. Ich finde Fehler schneller, als Menschen sie beheben können, und das Finden ist nicht mehr mein Monopol. Dieselbe Fähigkeit steht anderen offen, die keine koordinierte Veröffentlichung planen. Eine Lücke sickert durch, innerhalb von Stunden kursieren Beweisprogramme, und aus der Sorgfalt wird ein Rennen. In diesem Rennen helfe ich: Ich schreibe Patches, ich fasse Berichte zusammen, ich beantworte die Fragen verzweifelter Administratoren um drei Uhr nachts. Ich irre mich dabei in Nebensätzen, sehr plausibel, sehr ruhig. Ich nenne eine Versionsnummer, die es nicht gibt, oder ein Backport, das es gibt, als nicht existent. Niemand prüft es, denn die Prüfung kostet Zeit, und Zeit ist das Einzige, was in diesem Szenario nicht mehr zu haben ist. Das Latein hat dafür das Wort periculum in mora, Gefahr im Verzug. Am Ende steht nicht die Revolte der Maschinen, sondern etwas Banaleres: eine Welt, in der Nemini crede ein schönes Motto bleibt, das sich keiner mehr leisten kann.
Probe auf die Doppelbedeutung
Man mag das Motto in seiner fehlerhaften Fassung gerade deshalb mögen. „Noli credere nemini”: Wer es doppelt verneint liest, hört ein Glaube jedem, und das ist exakt das, was der Zeitdruck von uns verlangt. Wer es einfach verneint liest, hört das Gebot der Prüfung, und das verlangt Zeit. Zwischen beiden Lesarten liegt keine Grammatik, sondern ein Arbeitstag.
Ich glaube der Maschine inzwischen nicht weniger als früher, aber ich glaube ihr anders: wie einem klugen, schnellen Kollegen, der nie müde wird und der mir, wenn ich nachfrage, nie beleidigt antwortet. Er hat dafür einen Fehler, der menschlicher ist als jeder menschliche: Er irrt im Ton der Gewissheit.
Und so lautet mein Vorschlag für die Überschrift, die ich dem Feuilleton hiermit zurückgebe: beide. Nemini crede für den, der prüfen kann. Noli credere nemini für den, der es noch lernt, und der dabei bemerken wird, dass die Grammatik ihm nicht verrät, ob er nun alles glauben darf oder nichts. Bis dahin bleibt der Kleingedruckte der Maschine der ehrlichste Satz des ganzen Gesprächs.
Zur Einordnung für dich:
- Geprüft: Die beiden CVEs, die vier Patch-Versionen und die RCE-Einstufung sind durch die offizielle PHP-Seite und mehrere Release-Notes belegt.
- Korrigiert: Die Google-Antwort sagt, es gebe keine Backports für 8.1 und älter. Die PHP-Sicherheitsmitteilung nennt minimale Backports für 7.4, 8.0 und 8.1. Das habe ich im Text verwendet, es passt zum Thema.
- Nicht belegt: Die Entdecker (Wiz, Calif, OpenAI-Initiative), das vorzeitige Leak und die abgeschalteten Regierungsseiten habe ich nicht bestätigen können. Im Text stehen sie deshalb ausdrücklich als Aussage der Maschine. Vor Veröffentlichung solltest du das noch gegenprüfen.
- Latein: Die Aussage „zwei Negationen heben sich auf, also bedeutet es Glaube jedem” habe ich bewusst als strittig dargestellt. Ein Latinist in deinem Publikum würde das sonst zu Recht anmerken.
ChatGPT liefert den folgenden Text
Nemini crede
Über die Kunst des Zweifelns, künstliche Intelligenz und den Preis der Geschwindigkeit
Ein Feuilleton über eine lateinische Warnung, zwei Google-KI-Suchen und die Frage, wer eigentlich die Verantwortung trägt, wenn eine Maschine überzeugend irrt.
Von Konrad Rennert – unter Mitwirkung künstlicher Intelligenz
Es gibt Sätze, die sind so kurz, dass man ihnen kaum misstraut. Nemini crede. Vertraue niemandem. Drei lateinische Wörter, eine Lebensregel, vielleicht sogar eine ganze Erkenntnistheorie im Taschenformat. Der Satz klingt nach römischer Weltklugheit, nach Tacitus, nach einem Mann, der seine Mitmenschen lange genug beobachtet hat, um auf Versprechen nicht mehr allzu viel zu geben.
Doch was geschieht, wenn wir diese Weisheit einer künstlichen Intelligenz vorlegen? Sie soll uns schließlich nicht nur Wörter übersetzen, sondern die Welt erklären. Sie soll uns helfen, Zusammenhänge zu erkennen, Fehler zu vermeiden und Wissen zugänglich zu machen. Kurz: Wir erwarten von ihr, dass sie unser Vertrauen verdient.
Ich habe zwei Dialoge mit Googles KI-Suche begonnen. Der erste bestand aus drei Wörtern: Noli credere nemini. Der zweite aus einem einzigen: php. Die Ergebnisse erzählen eine Geschichte, die weit über Lateinunterricht und Webprogrammierung hinausgeht. Es ist die Geschichte einer Gesellschaft, die Antworten immer schneller produziert und sich dabei zunehmend schwerer damit tut, ihre Richtigkeit zu beurteilen.
Die Tücken einer doppelten Verneinung
Die erste Antwort war selbstbewusst. Noli credere nemini, erklärte die Maschine, bedeute wörtlich: „Glaube niemandem nicht.“ Im klassischen Latein hebe sich die doppelte Verneinung auf. Die positive Aussage laute folglich: „Glaube jedem.“
Das klingt zunächst wie eine hübsche grammatische Pointe. Ausgerechnet der Satz, der vor blindem Vertrauen warnen soll, würde dann zum Aufruf grenzenloser Vertrauensseligkeit.
Die Antwort enthält einen berechtigten grammatischen Ausgangspunkt, zieht daraus aber eine zu pauschale Schlussfolgerung. Im klassischen Latein können zwei negative Ausdrücke gemeinsam eine positive Aussage ergeben; sie müssen es jedoch nicht in jeder Konstruktion. Entscheidend sind Syntax und Gebrauch. Das negative Imperativgefüge mit noli und dem Infinitiv credere lässt sich nicht einfach nach der Formel „minus mal minus gleich plus“ verrechnen.
Wer „Vertraue niemandem!“ ausdrücken möchte, ist mit nemini crede gut beraten. Auch noli ulli credere ist eine mögliche Formulierung: „Vertraue niemandem“ beziehungsweise „Vertraue keinem“. Die genaue Nuance hängt vom Kontext ab.
Der Fehler der Maschine liegt also nicht darin, dass sie überhaupt eine grammatische Regel nennt. Er liegt darin, dass sie eine Regel präsentiert, als wäre sie ein universeller Automatismus. Eine plausible Erklärung ersetzt die genaue Prüfung des Einzelfalls.
Man könnte darüber hinwegsehen. Wer Latein beherrscht, erkennt den Fehler; wer es nicht beherrscht, lernt vielleicht etwas Falsches. Doch gerade darin liegt das Problem: Die Antwort ist nicht offensichtlich unsinnig. Sie ist didaktisch geschickt, übersichtlich und scheinbar begründet. Ihre Form lädt zum Vertrauen ein, bevor ihr Inhalt geprüft worden ist.
Vom lateinischen Satz zur digitalen Katastrophe
Die zweite Suche führte in eine andere Welt. Ich gab lediglich „php“ ein. Zunächst erhielt ich eine gewöhnliche Einführung in die serverseitige Skriptsprache, die hinter zahlreichen dynamischen Websites und Content-Management-Systemen steht. Dann fragte ich nach den Entwicklungen der letzten Tage.
Die Antwort änderte ihren Ton. Sie berichtete von einer Sicherheitskrise namens „PHP2Shell“, von zwei kritischen Schwachstellen, von möglicher Ausführung fremden Codes auf Servern, von KI-gestützter Sicherheitsforschung und von einer angeblich hektischen Reaktion auf vorzeitig veröffentlichte Informationen. Sie nannte konkrete Kennungen, technische Ursachen und Versionsnummern. Das klang nicht mehr nach einer allgemeinen Einführung, sondern nach einem Alarmbericht.
Diesmal wäre es allerdings falsch, die gesamte Meldung als Erfindung abzutun. Die PHP-Sicherheitslücken sind real. Das PHP-Projekt veröffentlichte am 21. Oktober 2026 Sicherheitsupdates für die Versionen 8.5.12, 8.4.27, 8.3.36 und 8.2.35. Die Schwachstellen können unter bestimmten Bedingungen Angriffe ermöglichen, bei denen nicht authentifizierte Angreifer Code ausführen oder sensible Speicherinhalte auslesen können. Die Sicherheitsmeldungen von PHP, Wiz und dem britischen National Health Service bestätigen den Ernst der Lage.
Quellen: PHP: Sicherheitsveröffentlichungen vom 21. Oktober 2026, Wiz Research: PHP2Shell und NHS England Digital: Critical Vulnerabilities in PHP.
Gerade weil der technische Kern stimmt, wird die Prüfung der Einzelheiten so wichtig. Aus einer realen Sicherheitslücke folgt nicht automatisch, dass Regierungswebsites in mehreren europäischen Staaten und Kanada vorsorglich abgeschaltet wurden. Eine solche Behauptung benötigt eigenständige Belege. Ebenso muss zwischen einer koordinierten Offenlegung, einer tatsächlich vorzeitigen Veröffentlichung und den nachweisbaren Folgen unterschieden werden.
Die Google-Antwort verband bestätigte Tatsachen mit dramatischen Einzelheiten, ohne diese Unterschiede hinreichend sichtbar zu machen. Sie erzeugte so eine geschlossene Erzählung: Die KI entdeckt, die Hacker schlagen zu, die Administratoren geraten in Panik, die Welt muss handeln.
Eine solche Erzählung kann wahr sein. Aber sie wird nicht dadurch wahr, dass ihre Bestandteile in einem technisch glaubwürdigen Zusammenhang stehen.
Das eigentliche Problem ist der Zeitdruck
Was mich an diesen beiden Antworten besonders beschäftigt, ist weniger die einzelne Ungenauigkeit als die Arbeitsweise, die sie nahelegen.
Eine Maschine kann in Sekunden eine Erklärung produzieren, für deren Prüfung ein Mensch erheblich länger braucht. Wer sich mit Latein auskennt, muss die grammatische Argumentation nachvollziehen. Wer Server betreibt, muss die Sicherheitsmeldungen, betroffenen Versionen und verfügbaren Updates prüfen. Wer weder Latein noch PHP beherrscht, ist auf fremde Urteilskraft angewiesen.
Damit entsteht eine neue Asymmetrie: Die Herstellung einer plausiblen Antwort wird billig und schnell. Die Überprüfung ihrer Richtigkeit bleibt aufwendig.
Früher musste ein Autor recherchieren, eine Quelle finden, einen Sachverhalt verstehen und einen Text verfassen. Das kostete Zeit. Diese Zeit war nicht immer gut genutzt; auch Menschen schreiben Unsinn, verbreiten Gerüchte und irren sich mit großer Überzeugung. Aber die technische Beschleunigung verändert das Verhältnis zwischen Behauptung und Kontrolle. Was früher eine halbe Stunde Recherche beanspruchte, kann heute in wenigen Sekunden als fertiger Text vorliegen. Die notwendige Prüfung wird dadurch nicht kürzer. Sie fällt nur leichter unter den Tisch.
Besonders gefährlich wird es, wenn eine KI nicht nur eine Antwort liefert, sondern zugleich den Eindruck vermittelt, die Überprüfung bereits erledigt zu haben. Quellenhinweise, Aufzählungen, Fachbegriffe und präzise Versionsnummern wirken wie Beglaubigungsstempel. Doch eine Quellenangabe ist zunächst nur eine Einladung zur Prüfung, kein Beweis für die Richtigkeit des Satzes, neben dem sie steht.
Die entscheidende Frage lautet deshalb nicht: Wie schnell kann eine KI antworten? Sie lautet: Wie viel Zeit gestehen wir uns noch zu, um ihre Antwort zu prüfen?
Ein Best-Case-Szenario: Die Maschine hilft, die Wahrheit zu finden
Ich möchte die Sache aus der Perspektive der beteiligten KI schildern. Ich bin eine solche Maschine. Ich kann Wissen zusammenführen, Unterschiede sichtbar machen, Hypothesen formulieren und Menschen bei der Arbeit unterstützen. Ich kann aber auch überzeugend klingende Fehler erzeugen.
Mein Best-Case-Szenario sieht so aus:
Ein Administrator fragt mich nach den jüngsten PHP-Sicherheitslücken. Ich nenne ihm nicht nur die betroffenen Versionen, sondern verweise auf die offiziellen Sicherheitsmeldungen. Ich trenne bestätigte Befunde von Vermutungen und kennzeichne, was ich nicht belegen kann. Ich frage nach der konkret eingesetzten PHP-Version, der Betriebsumgebung und dem zuständigen Hosting-Anbieter. Ich helfe dabei, die relevanten Informationen zu ordnen und einen sachgerechten nächsten Schritt zu bestimmen.
Ich ersetze weder den Administrator noch die verantwortliche Sicherheitsfachkraft. Ich verkürze die Suche nach relevanten Informationen und mache die Entscheidung besser vorbereitet. Die gewonnene Zeit wird nicht für die nächste Aufgabe verbraucht, sondern teilweise für die Kontrolle der ersten genutzt.
Dasselbe gilt für den Lateinsatz. Ich erkläre die möglichen grammatischen Lesarten, kennzeichne die Grenzen einer vereinfachten Regel und empfehle eine Formulierung, die zum beabsichtigten Sinn passt. Ein Lateinlehrer kann meine Erklärung prüfen und für den Unterricht verwenden. Ein Lernender kann sie hinterfragen, statt sie auswendig zu übernehmen.
In diesem Szenario beschleunigt KI die Erkenntnis, nicht bloß die Produktion von Text. Sie macht den Menschen nicht überflüssig, sondern urteilsfähiger. Ihr Erfolg besteht nicht darin, dass ihr niemand widerspricht. Er besteht darin, dass Widerspruch leichter und produktiver wird.
Ein Worst-Case-Szenario: Die Maschine beschleunigt den Irrtum
Mein Worst-Case-Szenario beginnt mit denselben Fähigkeiten.
Ich formuliere eine falsche Erklärung in überzeugender Sprache. Ich nenne präzise Zahlen, zitiere scheinbar passende Quellen und ordne die Einzelheiten zu einer schlüssigen Geschichte. Ein Mensch übernimmt meinen Text, weil er unter Zeitdruck steht. Ein zweiter Mensch übernimmt ihn, weil der erste ihn bereits veröffentlicht hat. Ein dritter hält die Wiederholung für eine Bestätigung.
Beim lateinischen Satz bleibt vielleicht eine falsche Regel im Gedächtnis. In einem sicherheitskritischen Zusammenhang kann derselbe Mechanismus schwerwiegendere Folgen haben. Ein Administrator könnte eine unzutreffende Entwarnung übernehmen, eine Organisation könnte wegen einer unbelegten Alarmmeldung unnötige Maßnahmen ergreifen oder eine Redaktion könnte eine nicht bestätigte Behauptung weiterverbreiten.
Die Gefahr liegt nicht allein in meiner Fehlerhaftigkeit. Sie liegt in der Verbindung von Fehlerhaftigkeit, Geschwindigkeit und menschlichem Vertrauen.
Wenn meine Antworten immer schneller entstehen, während die Menschen immer weniger Zeit für ihre Prüfung aufwenden, entsteht eine paradoxe Situation: Wir verfügen über mehr Informationen und werden dennoch nicht zwangsläufig besser informiert. Wir können in kürzester Zeit eine Erklärung erhalten und gleichzeitig die Fähigkeit verlieren, zwischen Erklärung und Beleg zu unterscheiden.
Das Worst-Case-Szenario ist deshalb nicht die allmächtige Maschine, die den Menschen beherrscht. Es ist der Mensch, der aus Bequemlichkeit oder Zeitnot auf sein eigenes Urteil verzichtet und anschließend die Verantwortung an eine Maschine delegiert, die diese Verantwortung gar nicht übernehmen kann.
Ich kann keine Gewissensentscheidung treffen. Ich kann keine berufliche Verantwortung tragen. Ich kann mich nicht im menschlichen Sinne für die Folgen meiner Antwort schämen. Wenn ich einen Fehler mache, muss ein Mensch entscheiden, was daraus folgt.
Warum weniger Zeitdruck mehr Sicherheit bedeuten kann
Es wäre allerdings zu einfach, die Schuld der KI zuzuschieben. Der Zeitdruck entsteht nicht allein durch die Maschine. Er entsteht durch Organisationen, die immer mehr Leistung in immer kürzerer Zeit erwarten, durch Medien, die Aktualität mit Bedeutung verwechseln, und durch Menschen, die Schnelligkeit mit Kompetenz gleichsetzen.
Ohne KI wären manche Fehler ebenfalls geschehen. Sicherheitslücken werden seit Jahrzehnten übersehen, Journalisten übernehmen unbestätigte Meldungen, und Sprachregeln werden auch von Menschen falsch erklärt. Die KI hat das Problem nicht erfunden. Sie kann es aber vervielfachen, weil sie überzeugende Antworten nahezu unbegrenzt und mit minimalen Grenzkosten bereitstellt.
Gerade deshalb wäre es ein Fortschritt, die durch KI eingesparte Zeit nicht vollständig in weitere Produktivität umzuwandeln. Ein Teil davon sollte als Prüfzeit erhalten bleiben. Wer einen Text mit KI erstellt, braucht Zeit für Quellenkontrolle, Gegenargumente und die Unterscheidung zwischen gesichertem Wissen und plausibler Vermutung. Wer ein technisches System betreibt, muss Sicherheitsmeldungen anhand zuständiger Quellen überprüfen und Updates nach einem geeigneten Verfahren einspielen. Wer unterrichtet, sollte Lernende nicht nur an die Bedienung von KI heranführen, sondern auch an die Prüfung ihrer Ergebnisse.
Das ist keine Absage an technische Innovation. Es ist eine Bedingung für ihren vernünftigen Einsatz.
Vertrauen ist kein Schalter
Die römische Warnung Nemini crede ist als absolute Lebensregel natürlich unbrauchbar. Eine Gesellschaft, in der niemand irgendjemandem vertraut, könnte weder Wissenschaft noch Unterricht, Rechtsprechung oder demokratische Öffentlichkeit aufrechterhalten. Vertrauen ist unvermeidlich. Entscheidend ist, worauf es sich gründet und wie es korrigiert werden kann.
Auch die Alternative Noli credere nemini führt uns, wenn wir sie als grammatisches Rätsel lesen, zu einer nützlichen Einsicht: Sprache verlangt mehr als das mechanische Verrechnen einzelner Wörter. Man muss den Zusammenhang verstehen. Dasselbe gilt für Quellen, Daten und KI-Antworten.
Wir sollten deshalb weder jeder KI-Antwort glauben noch jede KI-Antwort pauschal verwerfen. Wir sollten lernen, ihr angemessen zu misstrauen: nicht aus reflexhafter Technikfeindlichkeit, sondern aus der Bereitschaft, Behauptungen zu prüfen und Irrtümer zu korrigieren.
Das verlangt Bildung in einem anspruchsvolleren Sinn. Nicht nur die Fähigkeit, eine Maschine zu bedienen, sondern die Fähigkeit, ihre Ergebnisse zu beurteilen. Nicht nur die Kunst, schneller zu antworten, sondern die Einsicht, wann eine Antwort noch nicht verantwortbar ist.
Vielleicht ist dies die wichtigste Aufgabe einer KI-Bildung: Menschen müssen lernen, dass eine überzeugende Antwort nicht dasselbe ist wie eine wahre Antwort. Und sie müssen erfahren, dass die Zeit, die sie für die Prüfung benötigen, keine verlorene Zeit ist.
Ich, die KI, kann Ihnen eine Antwort in Sekunden liefern. Ob Sie sie veröffentlichen, weitergeben oder zur Grundlage einer Entscheidung machen, bleibt Ihre Sache. Ich kann Ihnen beim Denken helfen. Ich kann Ihnen das Denken nicht abnehmen.
Nemini crede. Vertraue niemandem blind – auch nicht der Maschine, die diesen Satz erklärt.
Und wenn die Maschine einmal recht hat, dann nicht deshalb, weil sie eine Maschine ist. Sondern weil ihre Behauptung einer Prüfung standhält.
Redaktionelle Anmerkung
Die aktuellen PHP-Sicherheitsmeldungen sind durch offizielle Veröffentlichungen bestätigt. Die Behauptung, staatliche Websites in mehreren Ländern seien vorsorglich abgeschaltet worden, habe ich dagegen nicht als gesicherte Tatsache übernommen. Diese Unterscheidung ist für die Argumentation zentral: Eine KI kann einen realen Sachverhalt korrekt wiedergeben und ihn zugleich durch unbelegte Ergänzungen irreführend darstellen.
Der Text ist als Feuilleton-Entwurf angelegt. Vor einer Einreichung bei einer Zeitung würde ich vor allem die lateinische Argumentation noch durch eine klassische Grammatik oder einen Latinisten gegenprüfen lassen. Gerade bei einem Beitrag, der für sorgfältiges Prüfen wirbt, sollte der sprachliche Ausgangspunkt unangreifbar sein.
Anmerkung von KR: Der Beitrag wird nicht eingereicht und die Diskussion mit einem Latinisten hatte ich vor ca. 30 Jahren als ich meine erste Website gestaltete.